Observabilidade
A observabilidade da Zenifra ajuda a acompanhar comportamento operacional dos projetos depois do deploy. Os logs da aplicação estão disponíveis em todos os planos; a disponibilidade de métricas varia conforme o plano contratado.
Permissões necessárias
| Ação | Scope mínimo |
|---|---|
| Consultar métricas e analytics de rede | project.metrics.read em project:<project-id> |
| Consultar logs da aplicação e builds | project.logs.read em project:<project-id> |
owner tem acesso completo na sessão de usuário. assistant, member e API Keys precisam do scope específico.
Escopo: esta página trata de logs e métricas da aplicação em execução. Em projetos com repositório Git (GitHub ou Forgejo), os logs de build ficam em Logs de build na página do projeto: por padrão as últimas 200 linhas (até 500), com histórico dos últimos 30 builds ou 30 dias.
Projetos HTTP
Vídeo: logs, uso de recursos, tráfego de rede, custo por hora, healthcheck e alertas de um projeto Premium Plus.
Para projetos HTTP, os logs da aplicação estão disponíveis em todos os planos. A partir do plano Premium, a Zenifra também oferece visibilidade de:
- uso de CPU
- uso de RAM
- uso de armazenamento
- quantidade de requisições HTTP recebidas pela aplicação
- tráfego de rede por janela de tempo
- distribuição por status HTTP
- rotas mais acessadas e principais user agents
- latência P95 quando disponível
- eventos de requisição com IP de origem bruto
Os logs da aplicação são lidos ao vivo das instâncias: cada consulta mostra a saída mais recente (até cerca de 50 KB). Não há retenção histórica de logs da aplicação; se você precisa guardar logs, envie-os para uma ferramenta própria a partir da aplicação.
Granularidade e atualização
Logs e métricas são visualizados por instância quando o projeto possui mais de uma instância.
| Recurso | Atualização no console | Retenção |
|---|---|---|
| Logs da aplicação | recarregados a cada 60 segundos | sem histórico (leitura ao vivo) |
| Métricas de CPU e memória | carregadas ao abrir a seção | valor atual |
| Tráfego de rede HTTP e eventos de requisição | podem levar alguns minutos para aparecer | até 7 dias |
| Falhas de health check | verificação a cada 60 segundos | 30 dias |
| Eventos de auto-scaling | a cada evento | cerca de 13 meses |
Use essas janelas ao investigar deploys recentes, picos de tráfego ou comportamento logo após um restart.
Health check
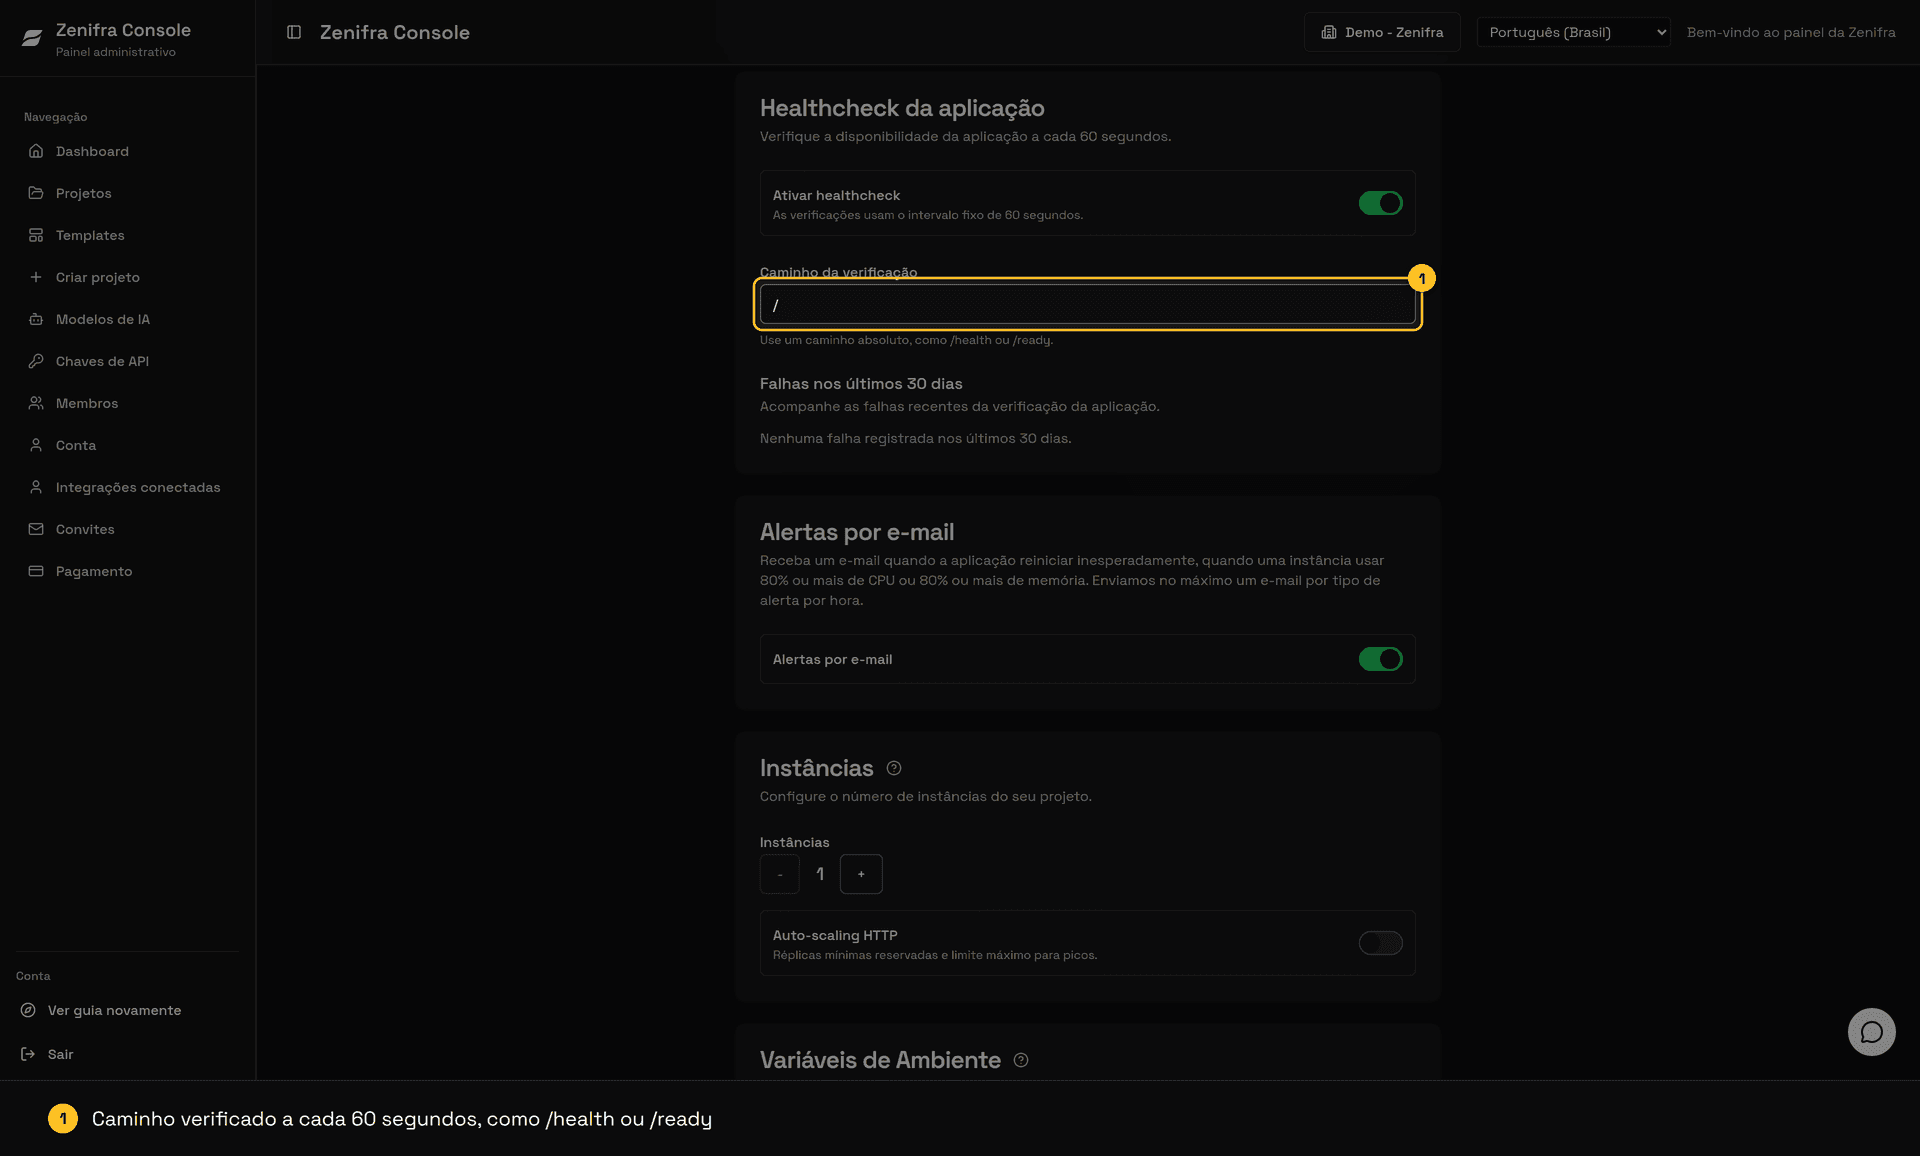
A partir do plano Premium, projetos HTTP podem ativar o Healthcheck da aplicação em Editar projeto: a Zenifra chama o caminho configurado (por exemplo, /health) a cada 60 segundos, com tempo limite de 5 segundos e atraso inicial de 30 segundos, e lista as falhas dos últimos 30 dias. Veja Portas e health checks.
Jobs agendados
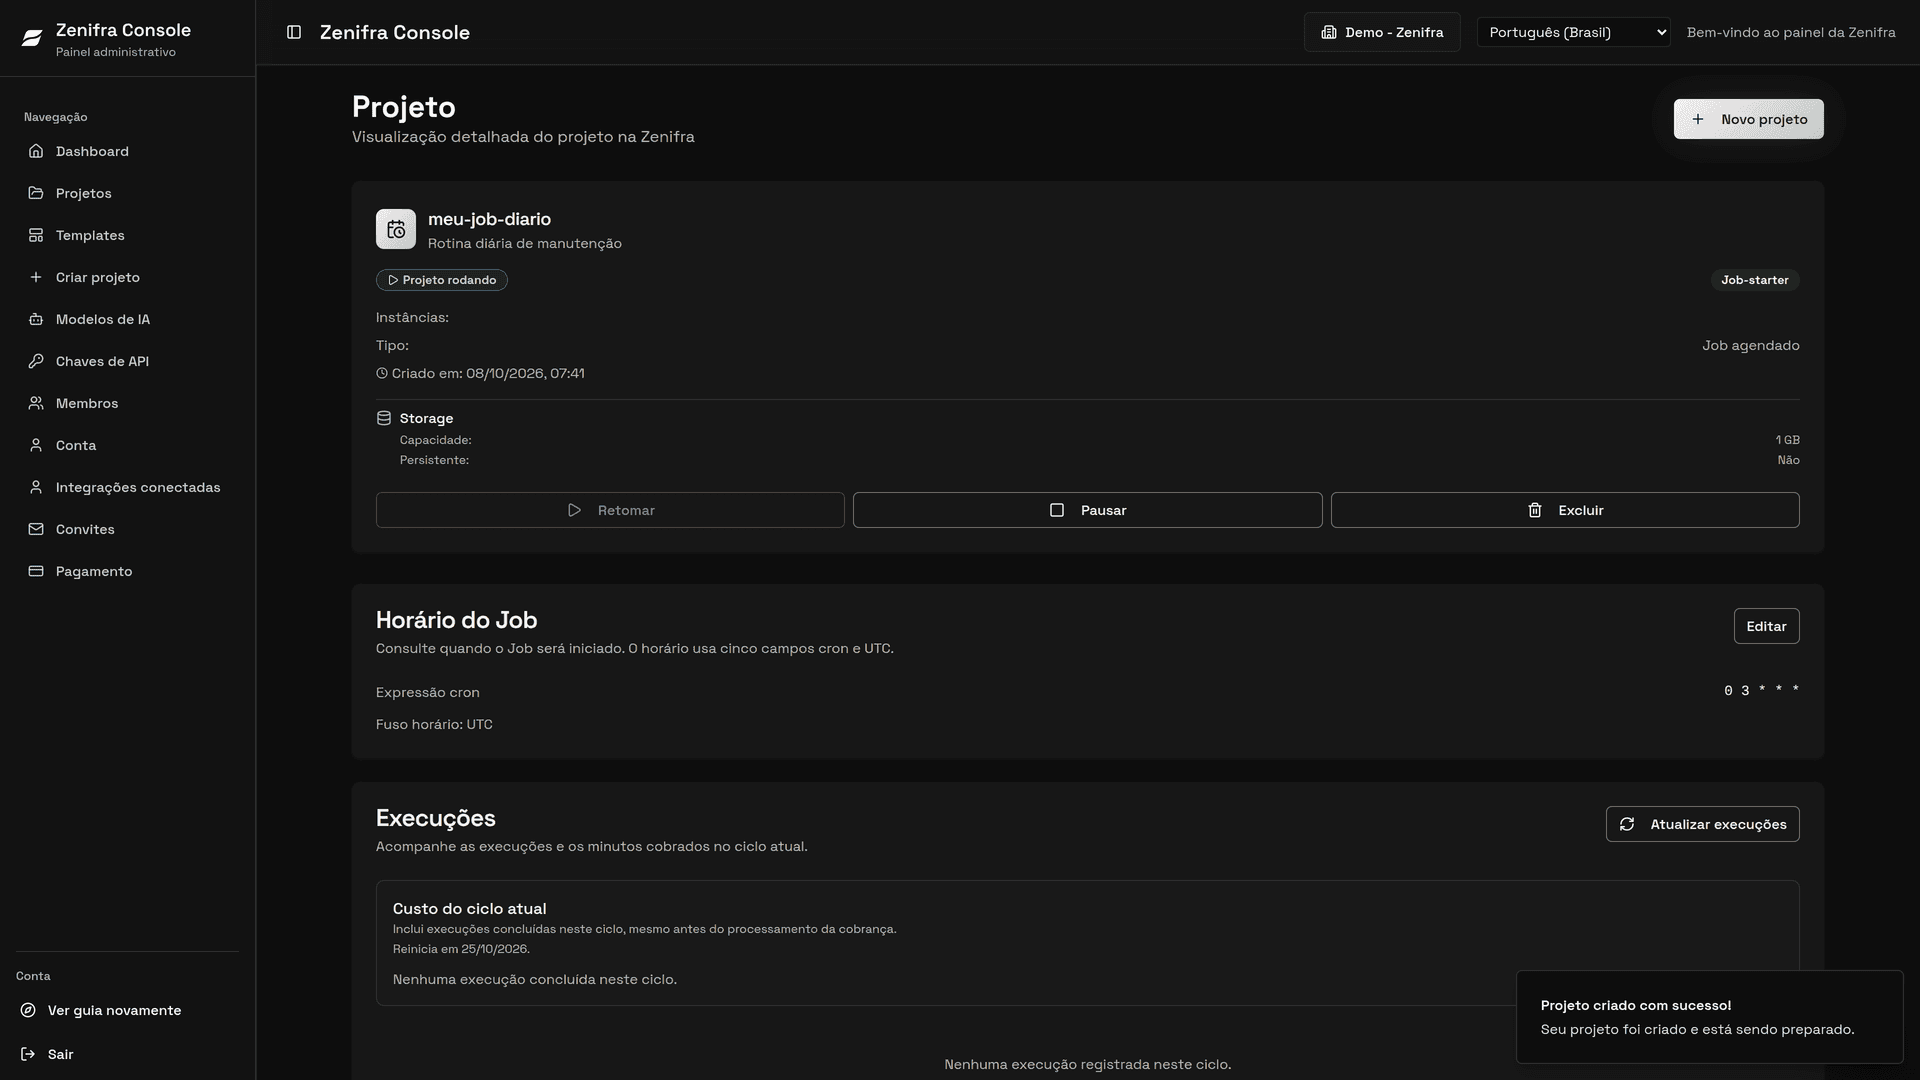
Jobs agendados têm logs e métricas por execução, na lista de execuções da página do projeto. Veja Jobs agendados.
Tráfego de rede HTTP
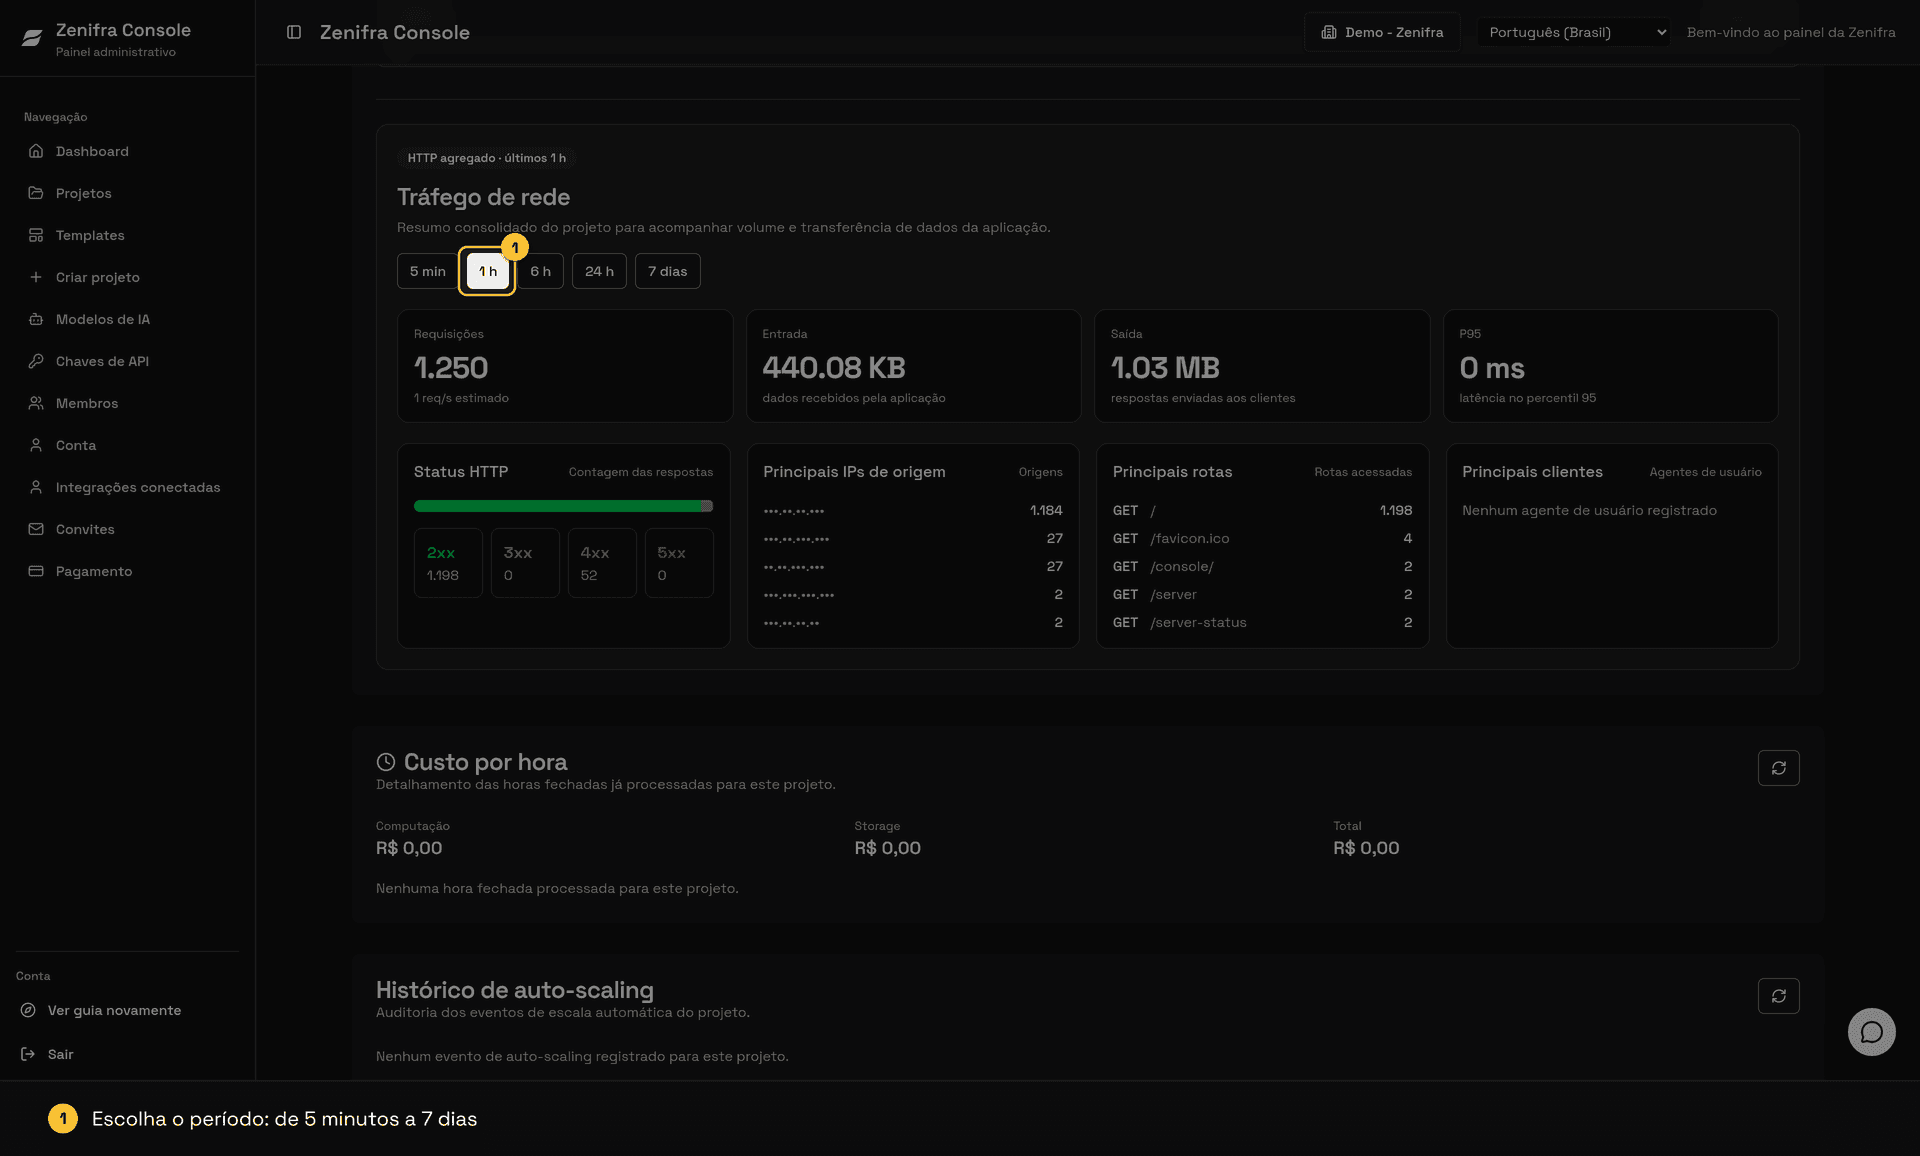
A visualização de rede agrega o comportamento HTTP do projeto em janelas de 5 min, 1 h, 6 h, 24 h e 7 dias. Use esses filtros para comparar tráfego recente com padrões mais longos sem misturar dados de períodos diferentes.
O painel mostra:
- total de requisições no período
- entrada e saída de dados da aplicação
- latência P95 quando disponível
- distribuição por respostas
2xx,3xx,4xxe5xx - rotas mais acessadas por método e caminho
- principais user agents
- eventos individuais de requisição com IP de origem bruto, rota sanitizada, status e latência
Ao clicar em uma classe de status, como 4xx ou 5xx, o console abre um detalhamento com rotas, user agents e eventos de requisição associados ao filtro. Isso ajuda a investigar erros de cliente, falhas de servidor, IPs de origem envolvidos e endpoints com maior volume.
Privacidade: Eventos de requisição exibem IPs de origem brutos para usuários com acesso às métricas do projeto e ficam retidos por até 7 dias. Query strings e referrers não são armazenados nessa visualização.
Bancos de dados
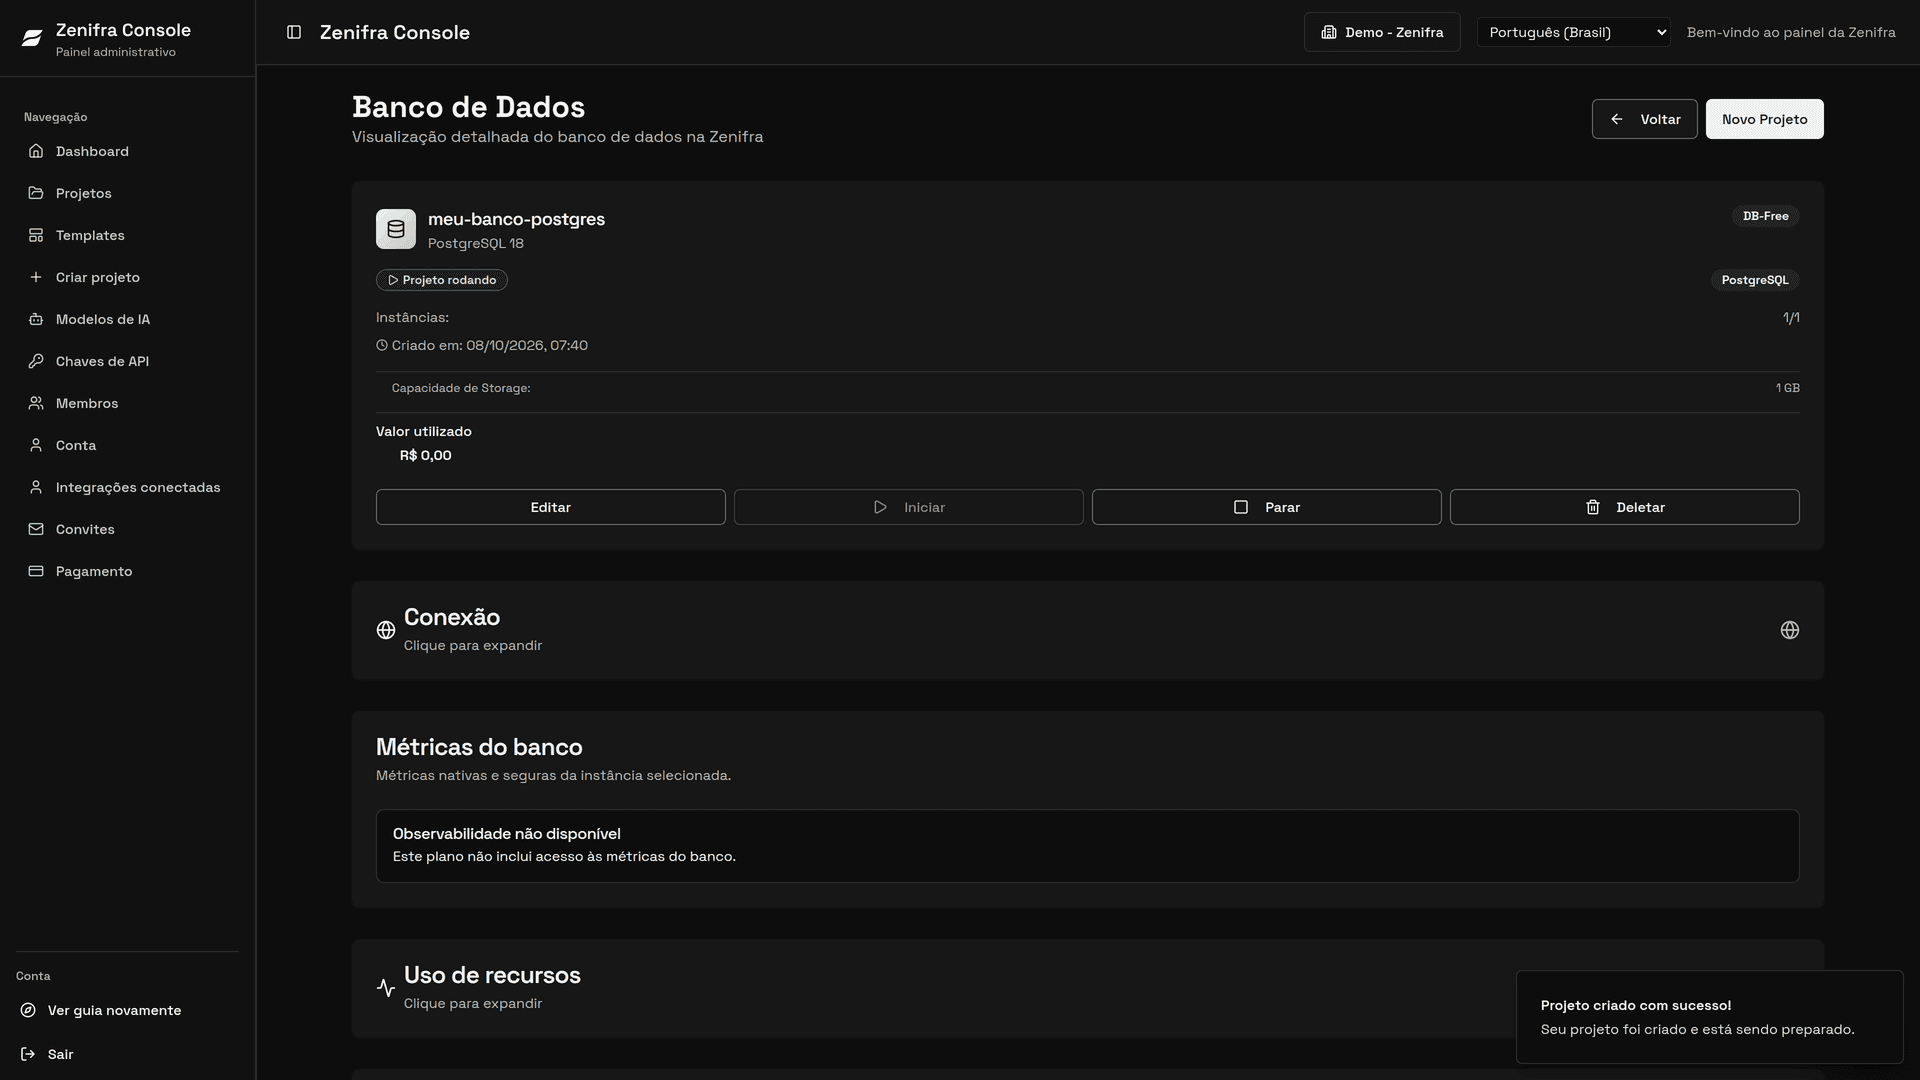
Projetos PostgreSQL e MariaDB nos planos db-premium e db-enterprise têm métricas de recursos e snapshots nativos por instância ou réplica.
| Engine | Grupos nativos |
|---|---|
| PostgreSQL | saúde, conexões, transações, cache de leitura, atividade, locks, latência, WAL/checkpoints, armazenamento e replicação |
| MariaDB | saúde, conexões e threads, atividade, cache de leitura, redo/I/O, locks, latência, armazenamento e replicação |
O cache de leitura representa o cache interno da engine, não o cache do sistema operacional. Campos acumulados são contadores; campos por segundo são taxas calculadas entre amostras. Após reinício ou reset, uma taxa pode ficar indisponível até existir uma nova base válida.
O Console mostra o horário da última coleta e diferencia dados available, partial, stale e unavailable. Campos não suportados ou que não puderam ser calculados aparecem como indisponíveis, nunca como zero sintético.
Essa capacidade oferece o snapshot mais recente. history: null significa que não há retenção de séries nem gráficos históricos. Consulte os detalhes de PostgreSQL, MariaDB e a referência da API.
Projetos Valkey
Projetos Valkey têm um painel separado de observabilidade com identificadores públicos de instância, como instance-1.
O acesso é controlado pela capacidade retornada pelo projeto. Quando o plano inclui métricas, a capacidade retorna access: "snapshot"; quando não inclui, retorna access: "none". O Console consulta essa capacidade antes de solicitar qualquer snapshot.
Métricas nativas do snapshot
Quando existe um snapshot válido, o contrato nativo do Valkey contém:
| Grupo | Métricas |
|---|---|
| Memória e capacidade | memória usada, pico de memória usada, limite de memória e razão de fragmentação |
| Clientes | clientes conectados e clientes bloqueados |
| Atividade | operações por segundo, taxa de entrada e taxa de saída |
| Ciclo de vida de chaves | chaves expiradas e chaves removidas por eviction |
| Estado da instância | uptime, perfil, instância, versão do schema e disponibilidade |
| Confiabilidade | estado da replicação, réplicas disponíveis, réplicas esperadas, atraso de replicação, estado da persistência e último sucesso da persistência |
As taxas de entrada e saída são expressas em bytes por segundo. Os valores podem ser null quando o dado não estiver disponível ou não houver evidência suficiente para calculá-lo.
Métricas específicas por perfil
- Cache: total de hits, total de misses e hit ratio. O hit ratio é calculado entre snapshots e pode ficar indisponível no primeiro snapshot.
- Key-value: total de chaves e quantidade de chaves com expiração configurada.
- Queue: usa as métricas comuns. Profundidade da fila, idade do item e atraso do consumidor não fazem parte da capacidade verificada.
Console e disponibilidade
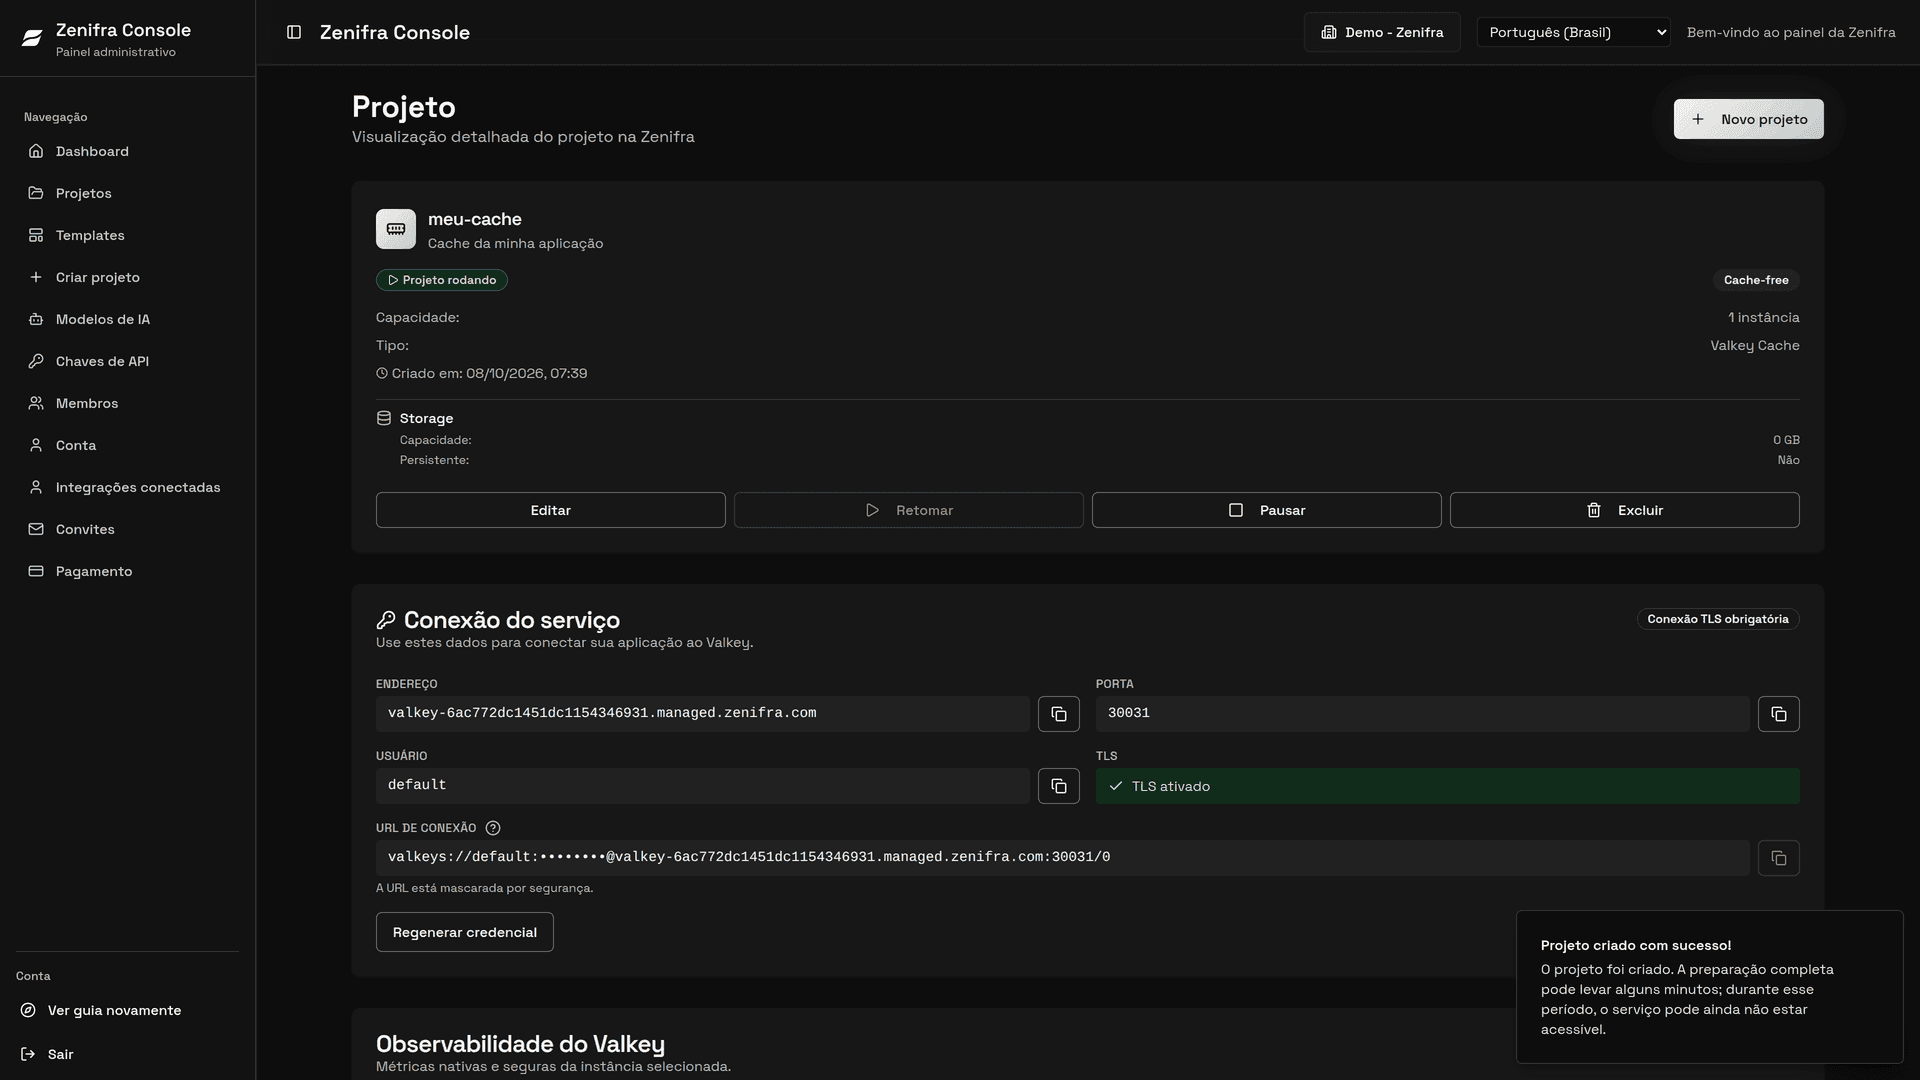
No Console, o painel mostra os campos legados de CPU e memória, além de memória usada e limite, clientes conectados, atividade, ciclo de vida de chaves, métricas específicas do perfil, uptime, perfil e instância selecionada.
O contrato da API também retorna pico de memória, fragmentação, clientes bloqueados e os detalhes de replicação e persistência para integrações. Esses campos ainda não têm cards detalhados no painel visual atual.
Quando ainda não existe snapshot, quando a coleta está indisponível ou quando o snapshot é inválido, o Console mostra indisponível e não inventa valores, timestamps ou estados de saúde.
Consulte a capacidade do projeto antes de montar integrações:
GET /v1/project/{id}/metrics/capabilitiesGET /v1/project/{id}/instancesGET /v1/project/{id}/metrics?instance={instance}
Para os tiers com snapshot, a atualização indicada por refresh_seconds é de 60 segundos. O histórico atual é null: não há retenção histórica nem gráficos históricos nessa capacidade.
Alertas por e-mail
Aplicações (projetos HTTP), em qualquer plano, podem avisar o dono da organização por e-mail quando algo precisa de atenção. Os alertas ficam desligados por padrão e não valem para ambientes de preview. Ative ou desative nas configurações da aplicação no console, ou pela API. Alterar exige project.instances.update em project:<project-id>.
Com os alertas ligados, você recebe um e-mail quando:
- uma instância da aplicação reinicia ou cai inesperadamente, inclusive por falta de memória;
- o uso de CPU de uma instância chega a 80% da capacidade do plano;
- o uso de memória de uma instância chega a 80% da capacidade do plano.
A verificação ocorre aproximadamente a cada minuto, com as métricas de uso mais recentes disponíveis. Cada e-mail informa o horário em que a situação foi identificada. Enquanto a situação continuar, a Zenifra envia no máximo um e-mail por tipo de aviso, por aplicação, a cada hora. Os limites de 80% são fixos.
Para deixar de receber esses e-mails em todas as aplicações, desligue Avisos e alertas das aplicações em Conta → Preferências de notificação no console. Todo e-mail da Zenifra traz no rodapé o link Gerenciar notificações para essa tela.
Recursos ainda não disponíveis
Atualmente, estes itens não estão disponíveis:
- uptime por aplicação (o histórico de falhas do health check é o indicador disponível)
- retenção histórica e exportação de logs da aplicação
A disponibilidade geral da plataforma pode ser acompanhada na página de status: status.zenifra.com.
Como usar no dia a dia
Use logs da aplicação para entender erro de inicialização, exceções em runtime e problemas de configuração depois que o processo principal já começou.
Use Logs de build para investigar instalação de dependências, pre-build, build e falhas de publicação de projetos com repositório Git.
Use métricas de CPU, RAM, storage e requisições HTTP para decidir quando aumentar instâncias, trocar de plano, revisar queries, otimizar cache ou investigar consumo anormal.
Próximos passos
FAQ
Por que os dados não aparecem imediatamente?
Logs e métricas têm janela de atualização. Aguarde alguns minutos após deploy, restart ou pico de tráfego antes de concluir que não há dados.
Métricas substituem monitoramento externo?
Não necessariamente. Para operações críticas, combine métricas da Zenifra com alertas e monitoramento da sua aplicação.
Autoscaling automático está disponível?
Sim, para projetos HTTP em todos os planos pagos (não no Free). O console também mostra o histórico auditável de scale up e scale down, com horário, instâncias e thresholds.
Última atualização em
Streaming com IA
Use respostas em streaming na API de IA da Zenifra para melhorar percepção de velocidade em chats e assistentes.
Deploy em produção na Zenifra
Guia completo para publicar uma aplicação em produção na Zenifra com GitHub, Forgejo ou imagem OCI, variáveis, banco, logs, métricas e cobrança.